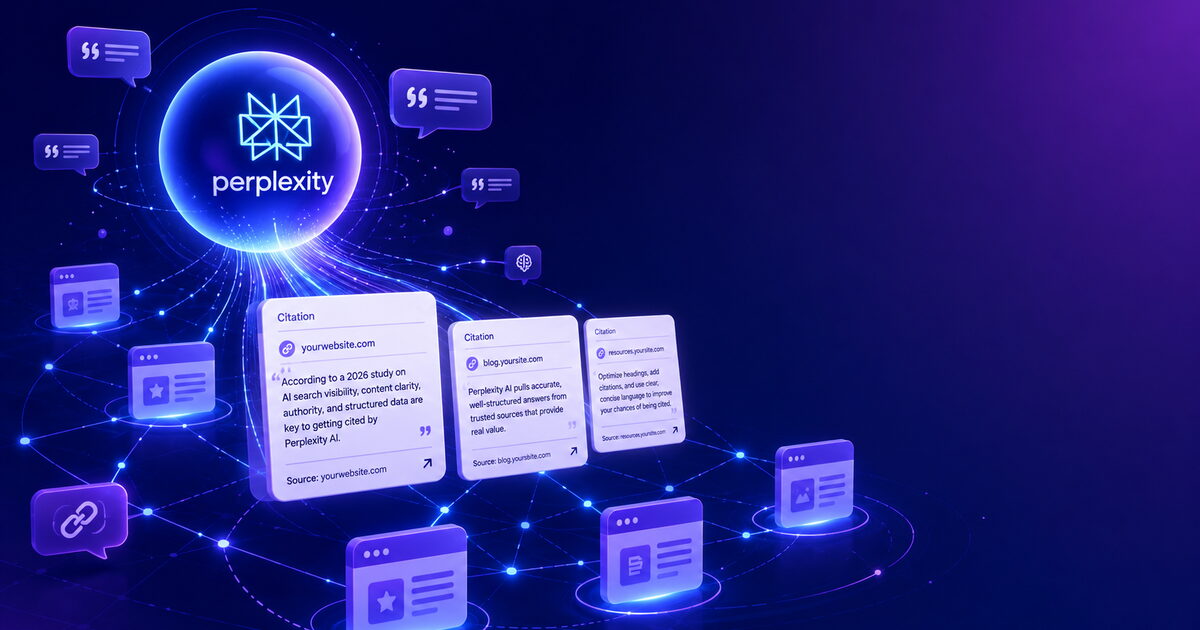
Para optimizar para Perplexity AI importan tres cosas: PerplexityBot debe poder rastrear sus páginas, cada página necesita una respuesta clara y concreta que sea fácil de citar, y sitios de terceros creíbles deben describir su negocio con exactitud. Perplexity no publica ninguna fórmula de posicionamiento y nadie ajeno a la empresa puede prometer una cita, así que esta guía separa lo que Perplexity documenta (el acceso de los rastreadores) de la práctica fundamentada (estructura del contenido, menciones, medición).
Perplexity es un motor de respuestas: redacta una respuesta breve y muestra a su lado enlaces numerados a las fuentes. Eso lo convierte en un canal que puede comprobar a mano y seguir en su analítica. A continuación verá cómo funcionan sus rastreadores, en qué se diferencia de ChatGPT y de las funciones de IA de Google, un proceso paso a paso y una rutina de medición.
Permita PerplexityBot en robots.txt, asegúrese de que su cortafuegos no lo bloquee, ponga una respuesta directa y breve bajo cada encabezado importante, mantenga los datos con fuente y con fecha y consiga menciones precisas en otros sitios creíbles. Después pruebe cada mes sus preguntas objetivo en Perplexity y vigile «perplexity.ai» en su analítica. Nada de esto garantiza una cita.
¿Qué es el SEO para Perplexity y por qué importa?
El SEO para Perplexity es el trabajo de hacer que su sitio sea rastreable, citable y creíble para que Perplexity pueda encontrar sus páginas y pueda enlazarlas como fuentes en una respuesta. Es una parte de la disciplina más amplia que cubre nuestra guía de optimización para motores generativos (GEO), y la mayor parte coincide con el SEO técnico habitual y con una buena redacción.
El motivo para ocuparse de ello es sencillo: cuando alguien hace una pregunta a Perplexity, solo las páginas que elige enlazar reciben una visita. Una página citada pone el nombre de su marca y un enlace ante alguien que está en pleno proceso de decisión; una no citada no consigue nada. Aquí no citamos cifras de usuarios ni de cuota de tráfico, porque Perplexity no publica cifras auditadas y los números que circulan proceden de estimaciones de terceros. Mida sus propias referencias (vea la sección de medición) y decida cuánto esfuerzo invertir después de unos meses de datos reales.
¿Cómo encuentra y cita fuentes Perplexity?
Perplexity busca páginas relevantes para una pregunta, las lee y redacta una respuesta con enlaces a las fuentes que utilizó. Perplexity no ha publicado qué índices ni qué datos de socios combina, por lo que el proceso exacto no es público. Lo que sí está documentado es cómo se identifican sus rastreadores y cómo puede controlarlos.
PerplexityBot y Perplexity-User
La documentación de rastreadores de Perplexity describe dos agentes. PerplexityBot está diseñado para mostrar y enlazar sitios web en los resultados de búsqueda de Perplexity, y la página indica que no se utiliza para rastrear contenido destinado a modelos fundacionales de IA. Se aconseja a los propietarios de sitios que lo permitan en robots.txt si quieren aparecer en los resultados. Perplexity-User respalda acciones iniciadas por el usuario: cuando la pregunta de una persona activa una obtención, por lo general ignora las reglas de robots.txt, porque un usuario pidió esa página.
La misma página indica que los cambios en robots.txt pueden tardar hasta 24 horas en aplicarse. Si PerplexityBot está bloqueado por una regla de robots.txt, un ajuste del CDN o un plugin de seguridad que bloquea bots, la página no puede mostrarse a través de ese rastreador, por buena que sea.
Permita los rastreadores documentados: user agents, rangos de IP y robots.txt
La documentación de rastreadores de Perplexity enumera los identificadores exactos e indica que los números de versión pueden cambiar.
| Agente | Cadena del user agent | Rangos de IP publicados | robots.txt |
|---|---|---|---|
| PerplexityBot | Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot) | https://www.perplexity.ai/perplexitybot.json | Perplexity recomienda permitirlo |
| Perplexity-User | Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user) | https://www.perplexity.ai/perplexity-user.json | Por lo general ignora las reglas de robots.txt |
Una entrada mínima de robots.txt que nombra al rastreador de búsqueda tiene este aspecto:
User-agent: PerplexityBot
Allow: /
Si su grupo User-agent: * actual prohíbe algunas carpetas, copie también esas líneas Disallow en el grupo de PerplexityBot. La guía de robots.txt de Google explica que un rastreador solo aplica el grupo más específico que lo nombra, de modo que un grupo específico del rastreador sustituye al grupo * para ese rastreador. El archivo debe estar en la raíz del host, por ejemplo example.com/robots.txt, y no en una subcarpeta.
Una entrada de robots.txt no sirve de nada si un cortafuegos rechaza antes la solicitud. La documentación de Perplexity ofrece estos pasos para la lista de permitidos:
- Cloudflare: vaya a Security, después a Security rules, después a Create rule y luego a Custom rules. Haga coincidir cada user agent junto con sus propios rangos de IP, establezca la acción en Skip y coloque la regla por encima de cualquier regla que bloquee o plantee un desafío. La documentación advierte de que el Bot Fight Mode de Cloudflare no puede omitirse con reglas personalizadas.
- AWS WAF: cree un conjunto de IP para cada bot y después una regla Allow para cada bot que combine la coincidencia del conjunto de IP con una coincidencia de cadena en la cabecera User-Agent, y asigne a estas reglas números de prioridad más bajos que los de sus reglas de bloqueo.
- Haga coincidir juntos el user agent y el rango de IP. Cualquiera puede enviar una cadena de user agent, así que la cadena por sí sola no prueba nada. Actualice las reglas a partir de los archivos JSON con regularidad, porque Perplexity indica que las direcciones se actualizan con regularidad.
- Deje pasar el tiempo y confirme después en los registros. Los cambios en robots.txt pueden tardar hasta 24 horas en surtir efecto, y los cambios en el cortafuegos pueden tardar algún tiempo en propagarse.
Para comprobar si el rastreador está llegando, busque su nombre en el registro de acceso de su servidor web, por ejemplo grep -i perplexitybot access.log | tail (la ruta del registro depende de su alojamiento). Lea el código de estado de cada línea: 200 significa que la página se sirvió, mientras que 403, 429 o 503 significa que algo de su lado la está rechazando.
Una advertencia sobre el rastreo no declarado
El 4 de agosto de 2025, Cloudflare publicó una investigación en la que informaba de que Perplexity utilizaba rastreadores no declarados con user agents genéricos de navegador e IP rotativas cuando se bloqueaban sus rastreadores declarados, y Cloudflare retiró a Perplexity de su lista de bots verificados. Es una conclusión de Cloudflare sobre el comportamiento de Perplexity, no una guía para los propietarios de sitios. La consecuencia práctica para usted es más acotada: si no quiere que se use su contenido, no confíe solo en robots.txt, y si quiere que lo citen, permita explícitamente los agentes documentados.
¿Qué tipo de contenido se cita?
Perplexity no publica qué favorece, así que trate lo siguiente como una práctica acorde con cómo leen las páginas los motores de respuestas, no como una fórmula demostrada. Las páginas son más fáciles de citar cuando tienen:
- Una respuesta directa primero. Un encabezado formulado como pregunta, seguido de una respuesta de dos a cuatro frases antes del detalle.
- Sustantivos concretos en lugar de pronombres. «Carga diferida de las imágenes situadas bajo el pliegue» es citable; «esto lo mejora mucho» no lo es.
- Datos con fuente y con fecha. Una cifra atribuida a una organización con nombre y con enlace puede ser comprobada por los lectores y por el software.
- Estructura clara. Párrafos cortos, tablas para las comparaciones y listas numeradas para los procesos.
- Un autor con nombre y una fecha visible, que ayudan a los lectores a juzgar si deben confiar en la página.
- Algo original: sus propias mediciones, un ejemplo práctico o una opinión experta claramente expresada, en lugar de una paráfrasis de lo que dicen otros diez sitios.
Las páginas promocionales escasas y las que solo repiten a otros sitios dan a un lector, y a cualquier motor de respuestas, pocas razones para elegirlas. No podemos citar porcentajes de tasa de citas, porque no encontramos una fuente primaria para ninguno.
Perplexity frente a ChatGPT frente a las funciones de IA de Google
Los tres producen una respuesta escrita con enlaces a las fuentes, y los tres necesitan una página que pueda rastrearse y que sea útil. Las diferencias documentadas tienen que ver sobre todo con los rastreadores y los requisitos.
| Pregunta | Perplexity | Búsqueda de ChatGPT | AI Overviews / AI Mode de Google |
|---|---|---|---|
| Rastreador que puede permitir o bloquear | PerplexityBot (muestra sitios en los resultados); Perplexity-User para las obtenciones activadas por el usuario | OAI-SearchBot (búsqueda); GPTBot (entrenamiento); ChatGPT-User (activado por el usuario) | Googlebot, el mismo rastreador que la Búsqueda de Google |
| Marcado especial requerido | Ninguno documentado | Ninguno documentado | Google afirma que no se necesita ningún marcado schema.org especial |
| Elegibilidad | No publicada | Un sitio que se excluye de OAI-SearchBot no se mostrará en las respuestas de búsqueda | La página debe estar indexada y ser apta para mostrarse en la Búsqueda de Google con un fragmento |
| Dónde ver el tráfico | Su analítica, como una referencia del asistente | Su analítica, como una referencia del asistente | Search Console: Google indica que el tráfico de las funciones de IA se incluye en el informe de rendimiento bajo el tipo de búsqueda Web |
Fuentes: Perplexity, OpenAI y Google Search Central. Como los fundamentos se solapan, el trabajo para posicionarse en ChatGPT y para aparecer en las AI Overviews de Google se aplica también a Perplexity.
Paso a paso: cómo optimizar para Perplexity
Siga estos pasos en orden. El paso 1 va primero porque una página que no puede obtenerse no puede citarse.
- Compruebe el acceso del rastreador. Asegúrese de que robots.txt no prohíbe PerplexityBot, de que no hay ninguna etiqueta noindex olvidada en sus páginas clave y de que su cortafuegos o su CDN no devuelve un 403 al bot. Los registros de su servidor muestran si lo visita.
- Reescriba las páginas clave con la respuesta primero. Bajo cada encabezado importante, añada una respuesta breve que se entienda por sí sola. Un verificador de legibilidad ayuda a mantenerla sencilla.
- Cite la fuente y la fecha de sus datos. Enlace cada estadística a la página que la publica y muestre cuándo se revisó por última vez la página.
- Añada algo original. Una pequeña medición con sus propios datos, un ejemplo práctico o la opinión de un experto con nombre.
- Consiga menciones precisas en otros lugares. Resúmenes del sector, reseñas y conversaciones de comunidades que lo describan de forma coherente.
- Pruebe y haga seguimiento cada mes. Haga a Perplexity las preguntas de sus compradores, anote qué URL se citan y compárelo con el tráfico de referencia de su analítica.
Configuración técnica: acceso, velocidad y marcado
La configuración técnica es en su mayor parte la misma lista de comprobación que para Google. Perplexity no ha dicho que los datos estructurados afecten a las citas, y Google indica que no se necesita marcado especial para sus funciones de IA, así que trate el schema como buena higiene, no como una palanca de Perplexity.
| Elemento | Por qué importa | Nota |
|---|---|---|
| robots.txt | Controla si PerplexityBot puede obtener sus páginas | Permítalo de forma explícita si quiere aparecer; deje hasta 24 horas para que se apliquen los cambios |
| Reglas de cortafuegos / CDN | Un bloqueo a nivel de red anula un robots.txt permisivo | Revise los ajustes y los registros de protección contra bots |
| Sitemap XML | Ayuda a los rastreadores a descubrir páginas nuevas y actualizadas | Manténgalo preciso y automático |
| Datos estructurados | Describen el tipo de página a los buscadores | Deben coincidir con el contenido visible; consulte la introducción de Google a los datos estructurados |
| Velocidad de la página | Ayuda a los visitantes que hacen clic | Pruébela con PageSpeed Insights |
Una actualización respecto a consejos más antiguos: Google ha dejado obsoleto el resultado enriquecido de FAQ, y su documentación indica que la función ya no aparece en la Búsqueda de Google a partir del 7 de mayo de 2026 (página FAQPage de Google). Por tanto, el marcado FAQ es opcional; si lo conserva, asegúrese de que coincide con las preguntas y respuestas visibles. El generador de marcado schema y el generador de schema FAQ pueden producir un marcado válido.
Cómo estructurar el contenido para que pueda citarse
Redacte cada sección H2 de modo que un lector que llegue solo a ella la entienda igualmente: un encabezado claro, una respuesta directa y después detalle, ejemplos y una tabla o lista. Los sistemas que extraen pasajes funcionan mejor con secciones que no dependen de tres párrafos de contexto anterior.
Haga que cada sección se sostenga por sí sola
Evite «como se mencionó arriba» y «partiendo del punto anterior». Vuelva a nombrar el tema al comienzo de la sección. Las entradas de blog narrativas que fluyen de una sección a la siguiente son las que peor se citan.
Use las palabras con las que la gente pregunta realmente
Preguntas como «cómo consigo que me cite Perplexity» o «usa Perplexity el índice de Google» son la formulación que la gente escribe, así que use la forma natural en los encabezados cuando encaje. Investíguelas con nuestra guía de investigación de palabras clave antes de reescribir y no repita una frase por repetirla.
Cómo generar menciones de terceros
Las respuestas de la IA se nutren de páginas de toda la web, así que lo que otros sitios creíbles dicen de su negocio influye en que los datos sobre usted sean coherentes y comprobables. No tenemos datos verificados sobre cuánto peso da Perplexity a las menciones frente a los enlaces, así que trátelo como una inversión sensata, no como una palanca de efecto conocido.
- Ofrezca comentarios de experto a periodistas y publicaciones del sector, con un nombre y un cargo reales.
- Aparezca con equidad en los resúmenes de su categoría; esas páginas se citan por derecho propio.
- Participe con honestidad en las comunidades donde los compradores hacen preguntas, sin promoción plantada ni encubierta.
- Publique investigación original que otros puedan querer citar.
- Mantenga precisos su Perfil de Empresa de Google y sus fichas en directorios, para que su nombre, dirección y descripción coincidan en todas partes.
Conseguir menciones reales exige un ritmo constante de difusión y publicación, que es para lo que sirve un programa de marketing de contenidos.
Errores habituales
La causa más habitual de la ausencia es técnica: un rastreador bloqueado. Después vienen el contenido anónimo o sin fecha y las páginas sin una respuesta citable.
| Error | Por qué perjudica | Solución |
|---|---|---|
| Bloquear al rastreador en robots.txt o en el cortafuegos | La página no puede mostrarse a través de ese rastreador | Permita PerplexityBot de forma explícita y vuelva a revisar los registros |
| Sin autor ni fecha | Los lectores no pueden juzgar quién respalda la afirmación ni si está al día | Añada un autor con nombre y una fecha de revisión visible |
| Redacción narrativa sin respuestas directas | No hay nada que pueda extraerse con limpieza | Añada una respuesta breve bajo cada encabezado |
| Estadísticas sin fuente | Los lectores y el software no pueden verificarlas | Enlace al editor o elimine la cifra |
| Páginas obsoletas | Los datos desactualizados son una fuente más débil | Revise las páginas clave con una periodicidad fija |
Perplexity no cita mi sitio: una tabla de diagnóstico
Trabaje de arriba abajo, porque cada fila da por buena la anterior. Ninguna de estas correcciones garantiza una cita, pero cada una elimina un obstáculo conocido.
| Lo que ve | Causa probable | Cómo comprobarlo | Solución |
|---|---|---|---|
| Ninguna línea de PerplexityBot en el registro de acceso | Una prohibición en robots.txt, una regla de CDN o de protección contra bots, o simplemente la página aún no se ha descubierto | Abra /robots.txt, revise los ajustes de bots del CDN y confirme que la página está en su sitemap y enlazada internamente | Permita el bot, añada la regla de lista de permitidos descrita arriba y enlace a la página desde páginas que ya se rastrean |
| Las líneas del registro muestran 403, 429 o 503 | Un cortafuegos, un límite de frecuencia o un ajuste de bot-fight está rechazando la solicitud | Compare los códigos de estado de PerplexityBot con los de un visitante normal | Permita por user agent más el rango de IP publicado |
| Las líneas del registro muestran 200, pero nunca le citan | La página puede obtenerse pero no responde a la pregunta con más claridad o credibilidad que las páginas que se citan | Haga a Perplexity la pregunta exacta y lea las páginas que enlaza | Reescriba con la respuesta primero, añada datos con fuente y un elemento original |
| Le citan, pero con datos incorrectos o antiguos | Una página desactualizada, o datos incoherentes entre su sitio y sus fichas | Compare la página citada con los datos actuales | Actualice la página y su fecha visible, y corrija las fichas de terceros |
| Le citan, pero las visitas siguen siendo bajas | La respuesta satisface al lector sin que haga clic | Compare las URL citadas con las sesiones de referencia de su analítica | Dé una razón para hacer clic: una herramienta, una plantilla, un conjunto de datos o un ejemplo práctico que la respuesta no pueda contener |
Un ejemplo de redacción citable frente a no citable
Ejemplo ilustrativo (no es un cliente real). Versión uno: «Nuestra herramienta le ayuda a posicionarse mejor y a conseguir más tráfico con el tiempo». Versión dos: «Nuestro verificador de densidad de palabras clave cuenta cuántas veces aparece una palabra clave en una página, para que pueda detectar repeticiones excesivas antes de publicar».
La segunda nombra la herramienta y lo que hace, de modo que un desconocido podría citarla fuera de contexto y seguiría teniendo sentido. Úselo como prueba de intuición en cada frase clave: si necesita el párrafo que la rodea, reescríbala. Del mismo modo, «Según Google Search Central, no se requiere ningún marcado especial para las AI Overviews» es más sólido que «los expertos dicen que el schema importa», porque la afirmación está nombrada, es concreta y puede comprobarse.
Consejos avanzados
Una vez establecidos los fundamentos, los extras útiles son la supervisión y la coherencia, no los trucos.
- Haga una comprobación mensual de citas. Haga a Perplexity sus 15 a 20 preguntas principales de compradores, registre qué URL se citan y qué hacen ellas que la suya no hace.
- Intégrelo en su SEO actual. El rastreo, la calidad del contenido y la estructura se solapan casi por completo con el trabajo de nuestros servicios de SEO, así que no lo gestione como un proyecto aparte.
- Lea sus bloques de respuesta de forma aislada, como haría con una metadescripción, antes de publicar.
- Etiquete con parámetros UTM los enlaces salientes de las campañas para que las publicaciones como invitado y las inserciones de relaciones públicas puedan rastrearse hasta las consultas.
Cómo medir las referencias de Perplexity
Las visitas de Perplexity pueden encontrarse en su analítica como sesiones de referencia del dominio de Perplexity. Google Analytics también añadió un canal «AI Assistant» al grupo de canales predeterminado el 13 de mayo de 2026: las sesiones reciben el medio «ai-assistant» cuando el referente coincide con un asistente reconocido (notas de versión de GA4). La nota de Google cita ChatGPT, Gemini y Claude como ejemplos y no enumera qué asistentes se reconocen, así que revise sus propios informes para ver si las visitas de Perplexity llegan a ese canal o siguen apareciendo como referencias.
- En GA4, consulte sus informes de adquisición de tráfico y localice las sesiones cuya fuente contenga «perplexity». Los nombres de las fuentes cambian, así que use los valores exactos que vea.
- Abra el informe de páginas de destino de esas sesiones para ver qué páginas se citan y reciben clics.
- Siga por separado las conversiones de ese segmento. Los volúmenes suelen ser pequeños, así que juzgue la tendencia a lo largo de un trimestre, no de un mes.
- Pruebe a mano sus preguntas clave cada mes, porque una cita en la que nadie hace clic nunca aparece en la analítica.
- Reincorpore a su plan editorial lo que se cita como plantilla para la página siguiente.
Un registro de citas que puede copiar
Ejemplo ilustrativo (no es un cliente real). Mantenga una fila por pregunta y mes, en una hoja de cálculo. Las filas siguientes son inventadas para mostrar el formato.
| Pregunta probada | ¿Nos citó? | URL citada | Otros dominios citados | Siguiente acción |
|---|---|---|---|---|
| ¿Cómo permito PerplexityBot en robots.txt? | Sí | /how-to-optimize-for-perplexity-ai/ | docs.example.com | Añadir el comando de revisión del registro cerca del principio |
| ¿Cuál es la diferencia entre PerplexityBot y Perplexity-User? | No | ninguna | docs.example.com, blog.example.net | Añadir una definición de una frase bajo su propio encabezado |
| ¿Afecta el marcado schema a las citas de la IA? | No | ninguna | news.example.org | Comprobar si lo respondemos en las dos primeras frases de la sección |
A partir de un registro como este, una tasa de citas es el número de preguntas en las que le citaron dividido entre el número de las que probó. Si probó 20 preguntas y le citaron en 3, la tasa es 3 / 20 = 15%. Trate un solo mes como una muestra pequeña, ejecute cada pregunta al menos dos veces antes de registrarla y compare trimestre con trimestre en lugar de dar significado a un cambio de un punto.
Informe cada mes de las sesiones y las conversiones de este segmento junto con las orgánicas y las de pago, y lleve un registro de las preguntas en las que le citan, para que la atribución siga siendo honesta en lugar de supuesta.
Lecturas adicionales: Answer Engine Optimization (AEO): la guía completa de 2026.
Preguntas frecuentes
Permita PerplexityBot en robots.txt y en su cortafuegos, ponga una respuesta directa y breve bajo cada encabezado clave, cite la fuente y la fecha de sus datos y consiga menciones precisas en otros sitios creíbles. Perplexity no publica ninguna fórmula de posicionamiento, así que ningún paso garantiza una cita.
PerplexityBot es el rastreador que Perplexity documenta como diseñado para mostrar y enlazar sitios web en sus resultados de búsqueda. Perplexity aconseja permitirlo en robots.txt si quiere aparecer. Bloquearlo es decisión suya, pero implica que ese rastreador no puede mostrar sus páginas.
Perplexity-User es el agente que obtiene una página cuando la pregunta de una persona lo activa. Perplexity indica que por lo general ignora las reglas de robots.txt porque un usuario solicitó la obtención, de modo que robots.txt por sí solo no es una forma completa de controlarlo.
Perplexity no ha dicho que los datos estructurados afecten a las citas, y Google indica que no se necesita marcado especial para sus funciones de IA. Añada schema porque ayuda a los buscadores a entender la página y manténgalo coincidente con el contenido visible. Google ya no muestra resultados enriquecidos de FAQ.
Google muestra una lista de enlaces ordenada, mientras que Perplexity redacta una respuesta y enlaza unas pocas fuentes. Los fundamentos se solapan: páginas rastreables, respuestas claras, datos con fuente y una reputación creíble. La diferencia está en cómo se comprueban los resultados, probando preguntas en el asistente.
Es posible, porque una página clara, concreta y bien documentada puede ser útil independientemente del tamaño del sitio, pero no podemos prometerlo. Pruebe usted mismo sus preguntas objetivo y mida sus propias referencias antes de invertir mucho.
Sí, como sesiones del referente de Perplexity en su analítica. GA4 también tiene un canal AI Assistant añadido en mayo de 2026, así que compruebe si sus visitas de Perplexity aparecen allí. Las citas en las que nadie hace clic no aparecerán.
Busque en el registro de acceso de su servidor web el nombre PerplexityBot y lea el código de estado de cada línea. Un 200 significa que la página se sirvió, mientras que un 403, 429 o 503 significa que un cortafuegos o un límite de frecuencia está rechazando la solicitud. Verifique al visitante con los rangos de IP que publica Perplexity, porque una cadena de user agent por sí sola puede falsificarse.
Cree una regla de permiso que haga coincidir el user agent de PerplexityBot junto con los rangos de IP del archivo JSON publicado por Perplexity, y colóquela por encima de cualquier regla de bloqueo. La documentación de Perplexity ofrece pasos para Cloudflare y AWS WAF, y advierte de que el Bot Fight Mode de Cloudflare no puede omitirse con reglas personalizadas.
Perplexity recomienda permitir PerplexityBot, así que añada un grupo con User-agent: PerplexityBot y Allow: /. Copie en ese grupo las líneas Disallow que aún desee, porque un rastreador sigue el grupo más específico que lo nombra. Perplexity-User por lo general ignora robots.txt, así que use reglas de cortafuegos si necesita controlarlo.
No hay un plazo publicado. Perplexity indica que los cambios en robots.txt pueden tardar hasta 24 horas en aplicarse, pero que una página se cite y cuándo ocurra depende de factores que no publica. Juzgue el progreso a lo largo de al menos un trimestre.
Si desea ayuda para revisar el acceso de los rastreadores, la estructura de las páginas y la medición en su sitio, empiece por nuestro generador de marcado schema y nuestro generador de schema FAQ gratuitos, o consulte nuestros servicios de SEO y de marketing de contenidos. No prometemos citas ni posiciones. Contáctenos y respondemos en 1 día hábil, con condiciones mes a mes y preaviso de 30 días.
Descubra más de Arb Digital
Arb Digital — una agencia de marketing digital que atiende a clientes de todo el mundo, con métodos white-hat que respetan las directrices de Google y Bing — informes mensuales transparentes, mes a mes con preaviso de 30 días y sin posiciones garantizadas.